Customer Case 03
Fabric 데이터분석 플랫폼
프로젝트 개요
제약·바이오 기업에서 논문 PDF에 담긴 정보를 체계적으로 활용하기 위해 추진한 PoC입니다. 비정형 문서를 구조화해 데이터 자산으로 관리하는 것이 목적이었습니다.
폴라리스클라우드는 논문 PDF에서 AI로 추출한 키워드를 Microsoft Fabric 환경의 정형 테이블로 관리하는 구조를 구성했습니다.
| 업종 | 제약·바이오 |
|---|---|
| 수행 기간 | 2026.02.01 ~ 2026.03.20 |
| 적용 기술 | Microsoft Fabric(Lakehouse, Notebook, Data Pipeline), Azure OpenAI |
| 원천 연계 | CSV · Excel · API |
도입 배경
기존에는 사업군 연구와 관련된 PDF 논문을 파일 형식으로 두고 폴더 단위로 수기 관리했습니다.
- 인수인계 부담: 관리 담당자가 바뀌거나 인원이 개편되면 자료 보관과 탐색에 대한 인수인계가 필요했습니다.
- 핵심 내용 파악: 각 파일의 핵심 내용을 한눈에 파악하기 어려웠습니다.
논문 PDF의 키워드와 메타정보를 구조화해 관리할 수 있는 Fabric 기반 데이터 환경이 필요해졌습니다.
주요 구축 내용
핵심 키워드, 메타정보, 저장 위치 등 논문 정보를 체계적으로 관리할 수 있도록 Microsoft Fabric 환경을 구성했습니다. 이후 Azure OpenAI와 연계한 검색·조회 지원을 목표로 했습니다.
- Fabric 아키텍처 구성: Lakehouse에 Bronze-Silver-Gold 계층 구조의 아키텍처를 구축했습니다.
- 원천 데이터 연계: CSV, Excel, API 형태의 원천 데이터를 Fabric에 연계했습니다.
- AI 키워드 추출: Azure OpenAI로 논문에서 키워드를 추출했습니다.
- 데이터 가공·정형화: Notebook과 Data Pipeline으로 추출한 키워드 데이터를 계층 구조에 따라 적재·가공해 정형 테이블로 정리했습니다.
구축 현황
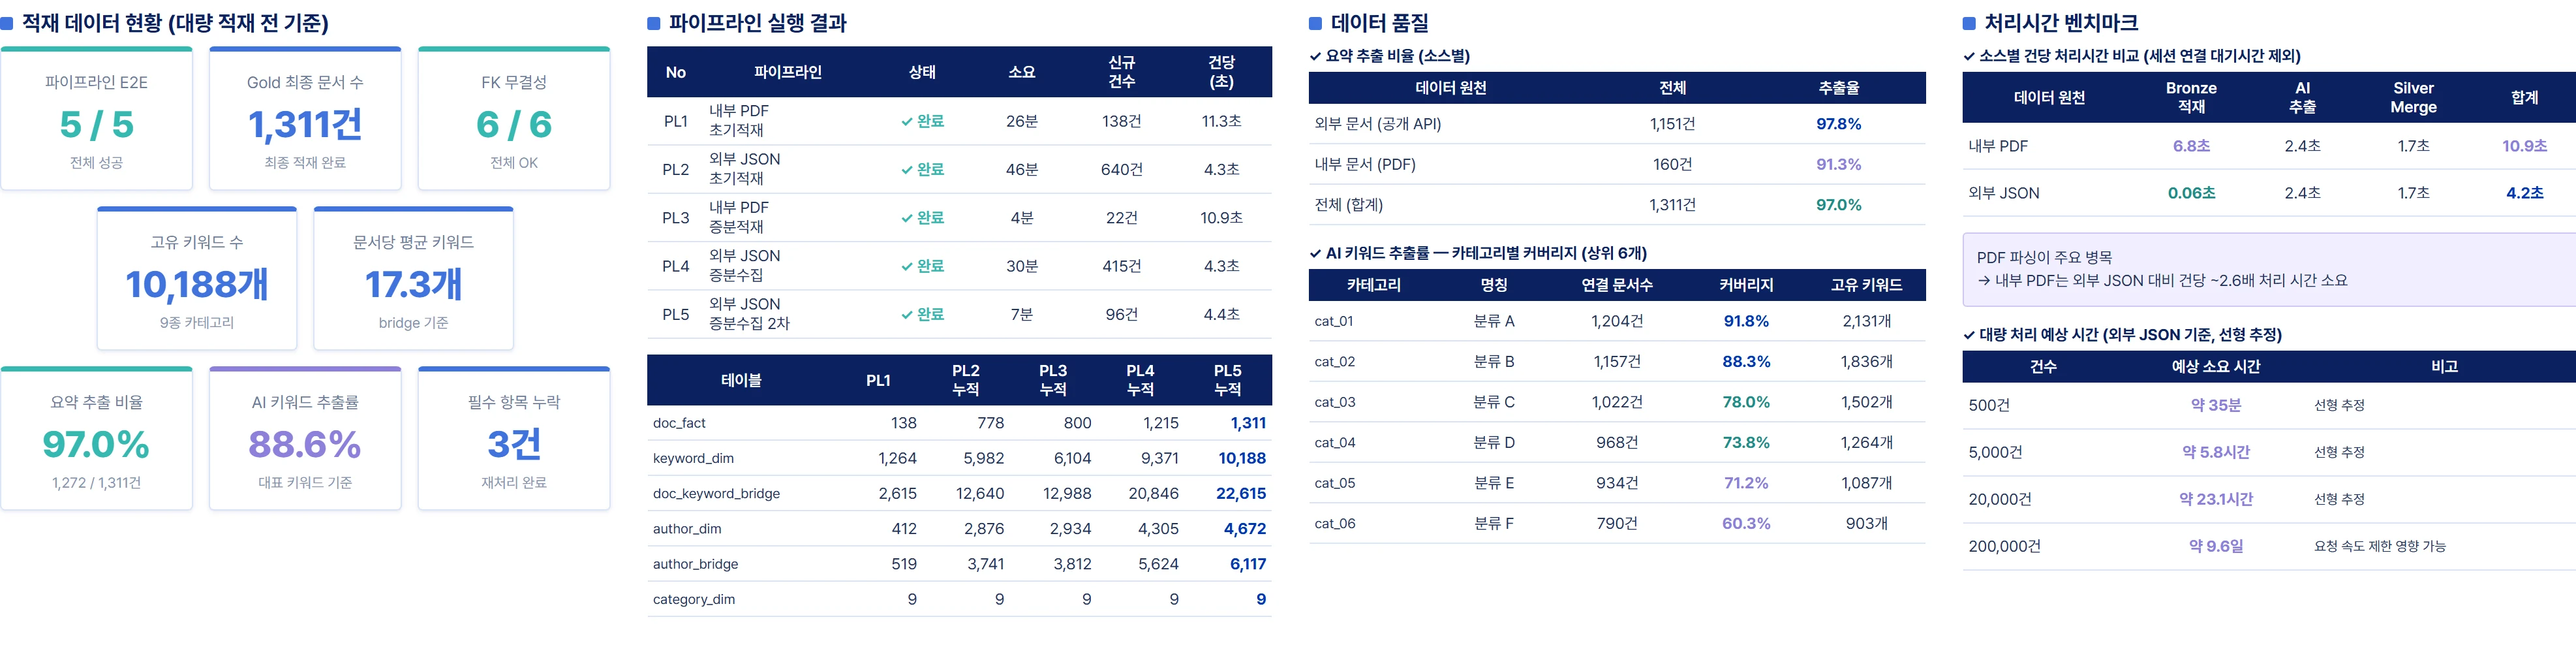
적재 데이터 현황, 파이프라인 실행 결과, 데이터 품질, 처리시간 벤치마크는 아래 이미지와 같이 정리했습니다.
구축 결과 및 변화
논문 PDF의 키워드와 메타정보가 정형 테이블로 관리되면서 문서 탐색이 쉬워졌습니다. Copilot 등 AI 기능과 연계하면 논문 요약 서비스도 이용할 수 있습니다. 구축 전후 비교는 아래 표에 정리했습니다.
| 구분 | Before | After |
|---|---|---|
| 관리 방식 | 파일 단위의 연구데이터를 폴더 단위로 수기 관리 | PDF 안의 주요 키워드와 메타정보를 정형화해 별도 보관 |
| 문서 탐색 | 각 파일의 핵심 내용 파악이 어려움 | 메타정보를 바탕으로 문서의 빠른 검색 지원 |
| 인수인계 및 활용 | 담당자 변경·인원 개편 시 자료 보관과 탐색에 대한 인수인계 필요 | Fabric 환경에서 정형 테이블로 관리해 향후 데이터 시각화와 AI 활용으로 이어갈 수 있는 기반 마련 |